微软 18 条人机交互准则:把论文方法拆成表格,拿来验收 AI SaaS
拆解微软研究院 CHI 2019 论文《Guidelines for Human-AI Interaction》:150 多条建议怎么压成 18 条、49 名从业者怎么在 20 款产品上验证、哪几条最常被违反。全部整理成表格,最后附一张给 AI SaaS 用的验收清单。
这篇论文是微软研究院 2019 年发在 CHI 上的《Guidelines for Human-AI Interaction》,作者 Saleema Amershi、Dan Weld、Eric Horvitz 等 13 人,正文 13 页。很多人只看过它那张 18 条准则的大表,但论文真正值钱的是另一半:这 18 条是怎么筛出来、怎么验证的。这套方法可以直接搬来给自己的 AI 产品做评审。
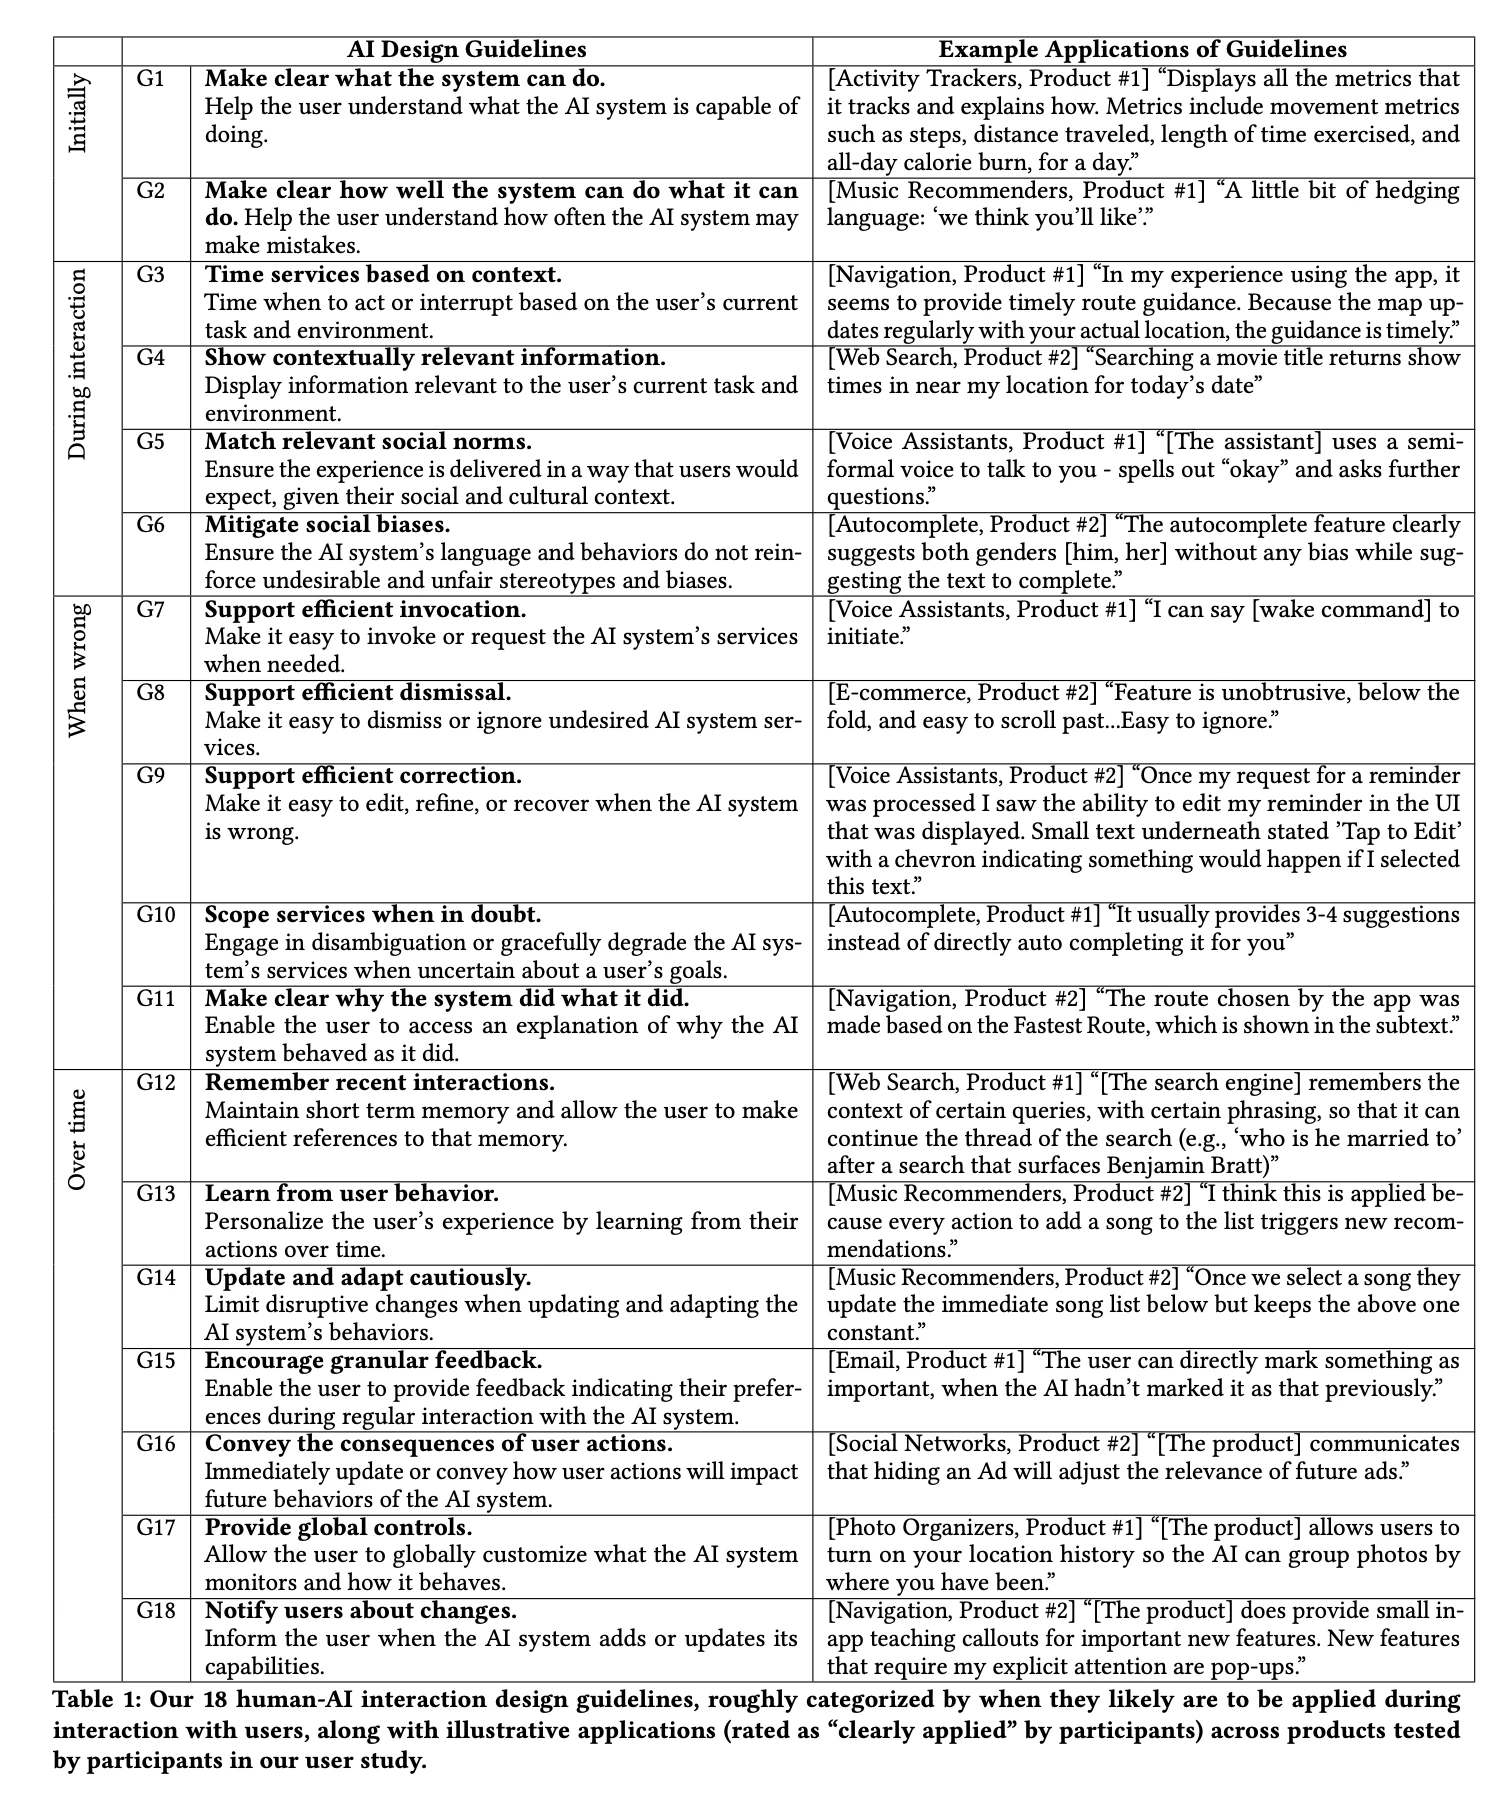
图片来源:Amershi et al.,《Guidelines for Human-AI Interaction》, CHI 2019, Table 1。DOI:10.1145/3290605.3300233
下面按论文的顺序,把方法、结果和结论都压成表格。
一、四个阶段:从 168 条建议到 18 条准则
| 阶段 | 输入 | 做法 | 产出 |
|---|---|---|---|
| 1. 归并准则 | 工业界内部准则、公开文章、学术论文 | 收集到 168 条候选建议;3 名成员做亲和图聚类,得到 35 个概念;剔除太空泛、太具体、不是 AI 特有的 | 20 条初版准则,按使用时机分 4 类 |
| 2. 内部启发式评估 | 20 条初版 | 11 名团队成员各挑 AI 产品,花 1 小时找每条准则的「做到」和「违反」,13 款产品 | 合并重复项、拆开带连词的、删掉观察不到的,剩 18 条 |
| 3. 用户研究 | 18 条 | 49 名 HCI 从业者,在 10 类共 20 款产品上逐条找例子、打 5 分制分数,并评价每条是否清楚 | 785 个例子,找出 56 处误读,改写措辞 |
| 4. 专家复评 | 改写后的 9 条 | 11 名资深 UX/HCI 专家对比新旧版本,评判易混淆的几对能否区分 | 定稿即 Table 1 |
有一处要澄清:网上流传的摘要说「20 余名从业者」验证,原文是第 3 阶段 49 人、第 4 阶段 11 人,作者自己写的是「另有 60 名设计和可用性从业者参与应用或评审」。
二、一条准则要写成什么样
第 2 阶段之后,作者给每条准则定了写法规范。这是整篇论文里最容易复用的部分,写团队设计规范、写 PRD 验收项都能直接套。
| 规则 | 原因 | 例子 |
|---|---|---|
| 动词开头,3–10 个词 | 读起来是一个动作,能直接判断做没做 | Support efficient correction. |
| 配一句话补充说明 | 消除歧义,不把解释塞进标题 | 「当 AI 出错时,便于编辑、细化或恢复」 |
| 不用连词 | 一条只检查一件事,评审时才能判断「做到 / 违反」 | 「支持高效调用、纠错和忽略」拆成 G7、G8、G9 |
三、哪些被合并、拆分、删掉
| 处理方式 | 原准则 | 结果 | 理由 |
|---|---|---|---|
| 拆分 | 支持高效调用、纠错和忽略 | G7 / G8 / G9 | 含连词,无法单独判断 |
| 合并 | 告知用户何时接管;适时转交人工 | 并入 G10 不确定时缩小服务范围 | 实际产品中很少单独出现,都是 G10 的特例 |
| 合并 | 允许修改隐私权限;提供隐私模式 | 并入 G17 提供全局控制 | 都属于全局设置 |
| 改名 | 允许粗粒度控制 | G17 加上「global」 | 评审者把改设置当成 G9 纠错 |
| 删除 | 适度地探索与利用(explore vs. exploit) | 删除 | 在界面上观察不到,属于模型层决策 |
| 删除 | 一开始要特别保守 | 删除 | 同上 |
四、用户研究怎么设计
| 维度 | 做法 |
|---|---|
| 选产品 | 汇总美国 13 份热门应用与网站榜单,取每份前 10;剔除冒犯性、游戏类、主功能不用 AI 的;按用途归成 10 类,每类按市场份额取 2 款,共 20 款,其中 2 款是微软的 |
| 选功能 | 每款产品只评一个最显眼的 AI 功能,如电商推荐、导航路线规划、邮件重要性过滤 |
| 选人 | 至少 1 年 HCI 经验、熟悉启发式评估;每款产品 2–3 人,遵循 Nielsen 的建议 |
| 评分 | 每条准则先判断「是否适用」,适用则给出例子,从「明显违反」到「明显做到」打 5 分 |
| 激励 | 50–70 美元礼品卡,附截图的例子越多给得越多 |
| 清洗数据 | 去掉重复 55 条;「找不到例子」误标为不适用的 73 条剔除;本是违反却标不适用的 20 条改判为违反;两名审核者意见不一致的 14 条剔除 |
10 类产品:电商、导航、音乐推荐、运动追踪、输入法自动补全、社交信息流、邮件、语音助手、相册整理、网页搜索。
五、18 条准则和它们的实测表现
下表的「做到 / 违反 / 不适用」是 20 款产品上的例子数,读自论文 Figure 1 的行合计,三列总和与正文的 313 / 277 / 106 一致。
| 阶段 | 编号 | 准则 | 做到 | 违反 | 不适用 |
|---|---|---|---|---|---|
| 初次接触 | G1 | 讲清系统能做什么 | 26 | 14 | 1 |
| 初次接触 | G2 | 讲清系统做得有多好 | 16 | 23 | 3 |
| 交互中 | G3 | 按情境把握时机 | 18 | 6 | 13 |
| 交互中 | G4 | 展示与情境相关的信息 | 26 | 9 | 6 |
| 交互中 | G5 | 符合社会规范 | 22 | 9 | 12 |
| 交互中 | G6 | 减少社会偏见 | 13 | 17 | 11 |
| 出错时 | G7 | 支持高效调用 | 20 | 11 | 5 |
| 出错时 | G8 | 支持高效忽略 | 23 | 14 | 5 |
| 出错时 | G9 | 支持高效纠错 | 17 | 20 | 2 |
| 出错时 | G10 | 不确定时缩小服务范围 | 9 | 17 | 10 |
| 出错时 | G11 | 解释系统为什么这样做 | 8 | 27 | 3 |
| 长期使用 | G12 | 记住最近的交互 | 28 | 13 | 4 |
| 长期使用 | G13 | 从用户行为中学习 | 22 | 12 | 4 |
| 长期使用 | G14 | 谨慎地更新和调整 | 18 | 4 | 6 |
| 长期使用 | G15 | 鼓励细粒度反馈 | 18 | 17 | 3 |
| 长期使用 | G16 | 告知用户操作的后果 | 11 | 21 | 6 |
| 长期使用 | G17 | 提供全局控制 | 13 | 29 | 5 |
| 长期使用 | G18 | 告知能力变化 | 5 | 14 | 7 |
作者用四条规则读这张表:
| 读法 | 含义 | 论文点名的准则 |
|---|---|---|
| 例子总数高 | 这条准则跟产品高度相关 | G1、G12、G17 |
| 做到明显多于违反 | 已被广泛实现,有成熟做法可抄 | G1、G4、G12 |
| 违反明显多于做到 | 重要,但还没人做好,是机会 | G2、G11、G17 |
| 不适用多 | 只对特定交互形态有效 | G3、G5、G6 |
几个细节:
- G11 解释原因违反最多之一,不适用却很少。说明评审者都能想到解释有用,只是产品不给。典型抱怨是导航总说「最佳路线」,却不说为什么最佳。
- G3 时机被很多人标成不适用,因为电商推荐、网页搜索都是用户主动拉取,产品不会主动打扰。这条只对会主动推送的产品重要。
- G10 和 G14 在社交和运动追踪产品上一个例子都没有。评审者说单次使用看不出来,要长期用才能发现。
- G5 和 G6 被评为最不清楚的两条。评审者很难跳出自己的文化背景去发现偏见,作者因此建议评审团队要多元。
六、最容易混淆的六对准则
| 混淆的一对 | 误读次数 | 改法 |
|---|---|---|
| G1 / G2 / G11 | 13 | 用平行句式区分:能做什么、做得多好、事后解释为什么 |
| G4 / G13 | 6 | 「当前情境」指当前任务和环境;「学习」指随时间积累的偏好 |
| G3 / G4 | 4 | 保留为两条,统一用「当前任务和环境」的措辞 |
| G12 / G13 | 7 | 记忆限定为短期的最近交互,学习是长期的 |
| G15 / G17 | 6 | G15 是单次交互里的反馈,G17 是影响所有行为的全局设置 |
第 4 阶段专家复评:9 条改写中有 8 条专家更喜欢新版;只有 G15 有 10 人偏好旧版,但新版能和 G17 分清,作者还是保留了新版。G1 和 G2 仍有 5 名专家认为难以区分。
七、照这套方法评审你自己的 AI SaaS
论文第 3 阶段的流程可以压缩成一次 1 小时的内部评审:
| 步骤 | 做法 | 产出 |
|---|---|---|
| 1. 定范围 | 只评一个核心 AI 功能,如「一键生成视频」 | 评审对象 |
| 2. 配对照 | 自家产品加 2–3 个竞品的同类功能 | 3–4 个评审对象 |
| 3. 配评审人 | 每个产品 2–3 人,至少一人不是这个功能的设计者 | 评审小组 |
| 4. 逐条打分 | 18 条逐条判断:不适用 / 明显违反 / 违反 / 中性 / 做到 / 明显做到,每条附截图 | 评分表 |
| 5. 清洗 | 「找不到」不等于「不适用」;不适用但实为缺失的,改判违反 | 干净的数据 |
| 6. 按四种读法排序 | 违反远多于做到、且竞品做到了的,优先修 | 改版清单 |
下面这张是我按 AI SaaS 场景改写的验收问题,评审时可以直接问:
| 编号 | 验收问题 |
|---|---|
| G1 | 首页或空状态是否用示例说清能生成什么、不能生成什么? |
| G2 | 是否告诉用户通常要试几次、什么情况容易失败? |
| G3 | 引导和提示是否在用户需要的那一步出现,而不是一进来就弹全部? |
| G4 | 模板和参数推荐是否跟当前项目相关? |
| G5 | 文案和生成内容是否符合目标市场的语言和文化习惯? |
| G6 | 生成的人物是否默认单一性别、肤色或职业形象? |
| G7 | 能否一键沿用上次参数「再来一版」? |
| G8 | AI 建议能否直接忽略,不强制弹窗? |
| G9 | 能否只改一部分,而不是整段重新生成?能否回退版本? |
| G10 | Prompt 有歧义时,是给几个方向让用户选,还是直接赌一个? |
| G11 | 是否展示用了什么模型、参考了哪些输入? |
| G12 | 能否引用「上一次那个风格」「同上」? |
| G13 | 系统是否根据用户的选择和删改调整默认推荐? |
| G14 | 换模型后,同一个 Prompt 的结果是否会突变?能否保留旧版本? |
| G15 | 能否针对单个结果点赞、点踩或标注「这段不要」? |
| G16 | 用户点踩后,是否说明这会影响之后的推荐? |
| G17 | 能否设置是否用我的数据训练、是否保存历史、默认风格? |
| G18 | 新模型、新能力上线时,是否在产品内说明变化? |
八、论文没覆盖、AI SaaS 要自己补的
以下三条不是论文内容,是我按生成式 AI 按量计费的现状补的。论文发表于 2019 年,评测的是推荐、搜索、语音助手这类产品,当时还没有生成式 AI 的计费和等待问题。
| 补充项 | 验收问题 | 关联的原准则 |
|---|---|---|
| 成本可见 | 生成前是否显示消耗的积分?失败是否自动退还? | G2、G9:积分焦虑会让用户不敢重试纠错 |
| 等待可控 | 几十秒的生成是否有进度、可排队、可离开页面并在完成后通知? | G3、G7 |
| 结果可比 | 是否一次给多个候选、可固定 seed、可对比版本? | G2、G10、G14 |
作者在讨论部分也承认了局限:准则刻意只收「看界面就能检查」的条目,「建立信任」这类原则被排除;高风险领域(自动驾驶、手术机器人、金融)需要专门的准则;语音助手、运动手环这类没有图形界面的产品,有些准则用不上。
如果只能先改三条,我会选论文里违反最多、AI SaaS 用户也最在意的三条:G2 讲清做得多好、G11 解释原因、G17 全局控制。竞品多半也没做好,做好了就是差异点。